 Quven


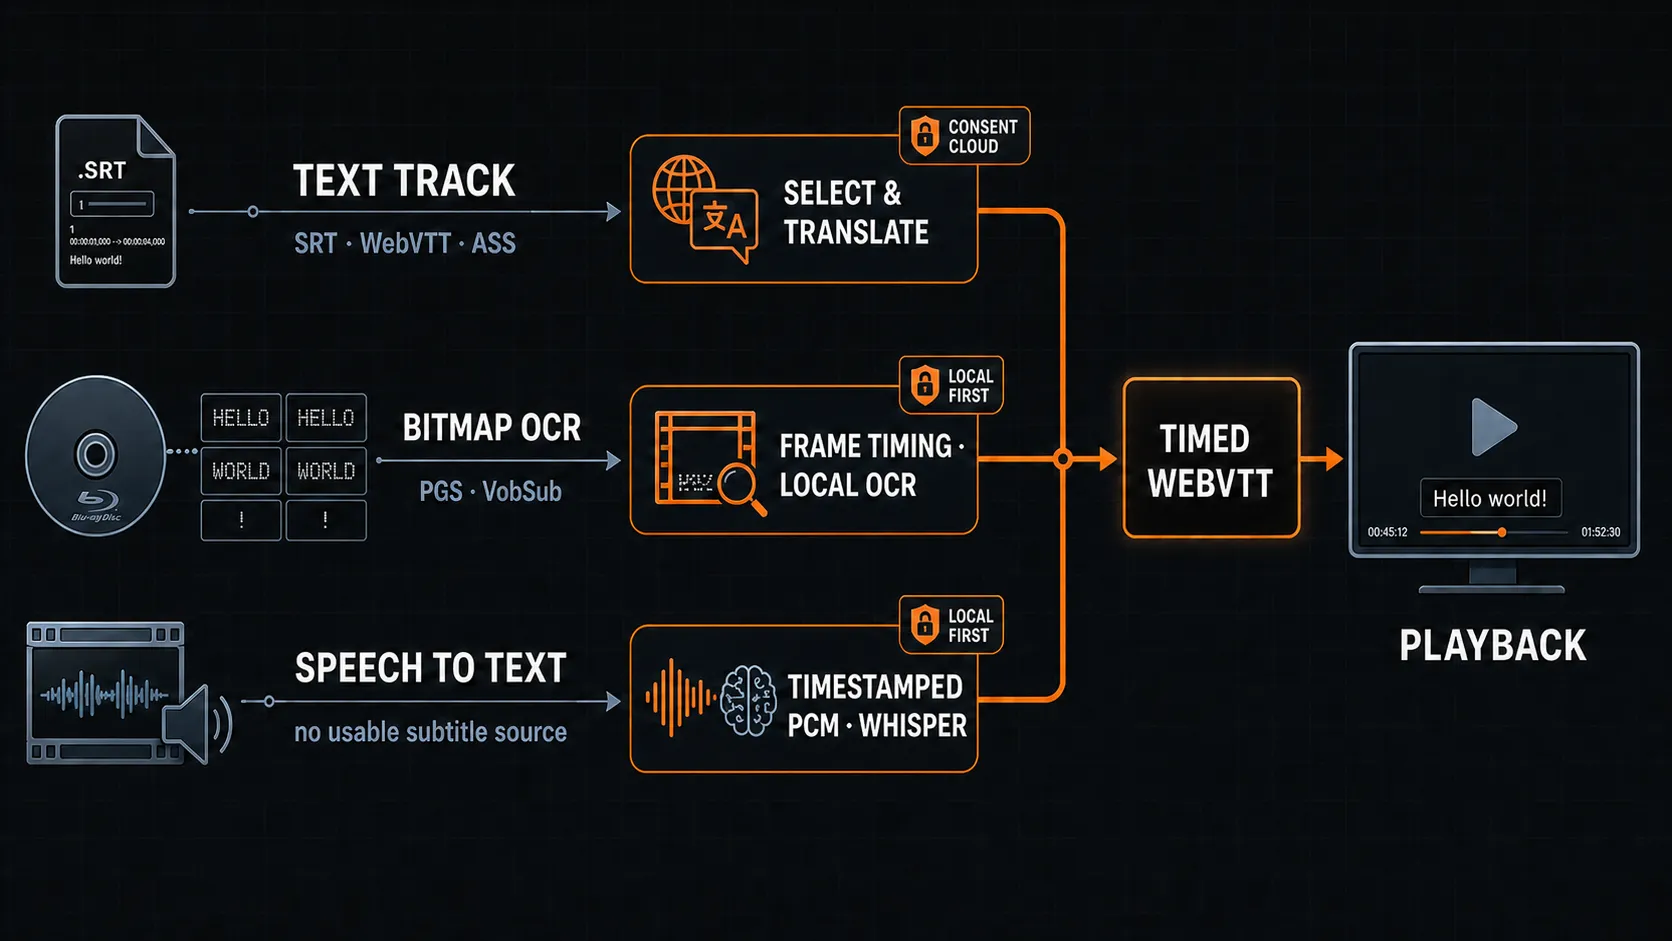
Nous avons déjà décrit la manière dont un serveur multimédia devrait traiter les sous-titres : traduire les pistes de texte existantes, appliquer une OCR locale aux pistes en images des DVD et des Blu-ray, et se replier sur l’écoute des dialogues lorsqu’un fichier ne contient rien d’exploitable. Trois chemins, qui aboutissent chacun à une piste de texte minutée.
Une telle architecture vaut uniquement par son comportement sur de véritables supports ; nous avons donc éprouvé chaque chemin sur de vrais disques et de vrais films. Trois détails ont déterminé si le résultat était exploitable, et aucun d’entre eux n’apparaît sur un fichier d’essai bien propre.
Associer chaque image PGS à sa réplique
Un Blu-ray contenant uniquement du PGS constitue le premier essai le plus difficile, et c’est précisément le bon. La piste ne contient aucun texte, seulement des images minutées, et le serveur doit associer chaque image à sa réplique avant que la reconnaissance puisse commencer :
- Lire le flux avec une fenêtre d’analyse plus large, car FFmpeg ne parvient pas à déterminer la taille d’un flux PGS avec l’analyse par défaut.
- Construire le graphe de filtres à partir des dimensions propres du sous-titre, et non de celles de la vidéo.
- Lire les plans de couleur, puisque le décodeur transmet des images à palette dont le plan alpha vaut uniformément zéro, alors que les glyphes se trouvent dans les plans de couleur.
- Soustraire l’heure de début du conteneur, car FFprobe rapporte des horodatages bruts tandis que FFmpeg recale sa sortie sur zéro.
La quatrième étape est celle qui décale discrètement chaque réplique lorsque personne n’en tient compte. Sur le disque utilisé, le conteneur commençait à 79 millisecondes, et chaque image serait donc arrivée en avance. Une fois les quatre étapes prises en charge, le disque a associé 984 de ses 984 images à leurs répliques, et la même correction permet au VobSub d’effectuer l’association par horodatage, 73 sur 73 sur le DVD mesuré.
Nous avons également envisagé une détection de scènes pour écarter les images transparentes que le PGS émet entre deux sous-titres, puis nous l’avons écartée. Deux répliques consécutives portant le même texte sont en effet considérées comme une absence de changement de scène, de sorte que l’une des deux disparaît, et une chaîne qui perd discrètement une ligne de dialogue ne mérite pas votre confiance.
Des transcriptions qui conservent les phrases entières
Le chemin audio comporte son propre piège. Un moteur de reconnaissance renvoie des segments de parole, et un sous-titre doit les afficher pendant une durée lisible : il s’agit de deux limites distinctes. Pourquoi les séparer ? Parce que la première relève d’un fait concernant l’audio et la seconde d’un choix concernant la lecture. Quven limite l’affichage d’une réplique à sept secondes, mais cette limite appartient à l’étape de minutage, qui scinde les répliques longues aux pauses naturelles et ne décide pas de l’endroit où le texte lui-même est coupé ; une réplique de dix secondes et demie reste ainsi une seule phrase. Des tests maintiennent ces deux limites séparées, et c’est pourquoi la transcription d’un film complet se lit comme un dialogue.
La reconnaissance vocale sur la carte graphique
Transcrire un film de deux heures avec le seul processeur demande environ huit minutes et mobilise tous les cœurs, ce que personne ne souhaite voir tourner en arrière-plan, et ce que vous ne devriez pas avoir à subir. La reconnaissance peut donc fonctionner sur la carte graphique, avec Metal sur macOS et Vulkan sur Windows et Linux, et sur la carte NVIDIA mesurée l’étape d’encodage est passée de 591 millisecondes à 15,7, tandis qu’un film de deux heures demande environ deux minutes et demie avec un processeur presque inactif.
La sélection descend une échelle : GPU dédié, GPU intégré, version optimisée pour le processeur, version de base pour le processeur ; une machine dépourvue d’adaptateur exploitable transcrit donc malgré tout, simplement plus lentement. La carte dédiée est choisie dans la liste des adaptateurs, car l’énumération revient dans l’ordre des pilotes, et sur le chemin processeur Quven laisse au moins un processeur disponible.
À quoi ressemble un sous-titre traduit
Nous avons relu ligne par ligne un épisode traduit complet, soit 740 répliques, en le comparant à l’original. Environ dix-huit répliques manquaient de précision, et une douzaine d’entre elles méritaient une correction, comme une expression idiomatique mal rendue ou une incohérence de continuité : un sous-titre avec lequel un film se regarde sans difficulté, et l’éditeur de répliques permet de traiter le reste.
Le chemin audio s’est également bien comporté. La traduction d’un film transcrit est revenue complète, 1 593 répliques sur 1 593, sans réplique vide ni fuite de la langue source. Il reste la limite propre au moteur de reconnaissance, une ligne grammaticalement correcte qui ne correspond pas tout à fait aux paroles de l’acteur, et c’est pourquoi un sous-titre rédigé par un auteur, lorsqu’il existe, passe toujours en premier.
Quelle partie relève de quelle offre
La génération d’un sous-titre à partir de l’audio s’exécute sur votre propre processeur et votre propre carte graphique, et elle est incluse dans Pro, tandis qu’une transcription déjà produite reste lisible gratuitement par toute personne pouvant ouvrir le titre. La traduction fonctionne différemment : le texte quitte la machine et passe par un fournisseur de modèle de langage payant, derrière une file de tâches qui résiste aux redémarrages, et chaque film représente donc un coût réel et mesurable. C’est pourquoi la traduction par IA est incluse dans Max et Lifetime, avec une allocation hebdomadaire partagée par les serveurs liés au compte, et la page des offres en précise les détails.
Les versions pratiques sont les guides consacrés à la traduction de sous-titres par IA et à la génération de sous-titres pour un film qui n’en possède aucun.
Communauté
Commentaires
0 commentaire
Aucun commentaire pour le moment. Lancez la conversation.