 Quven


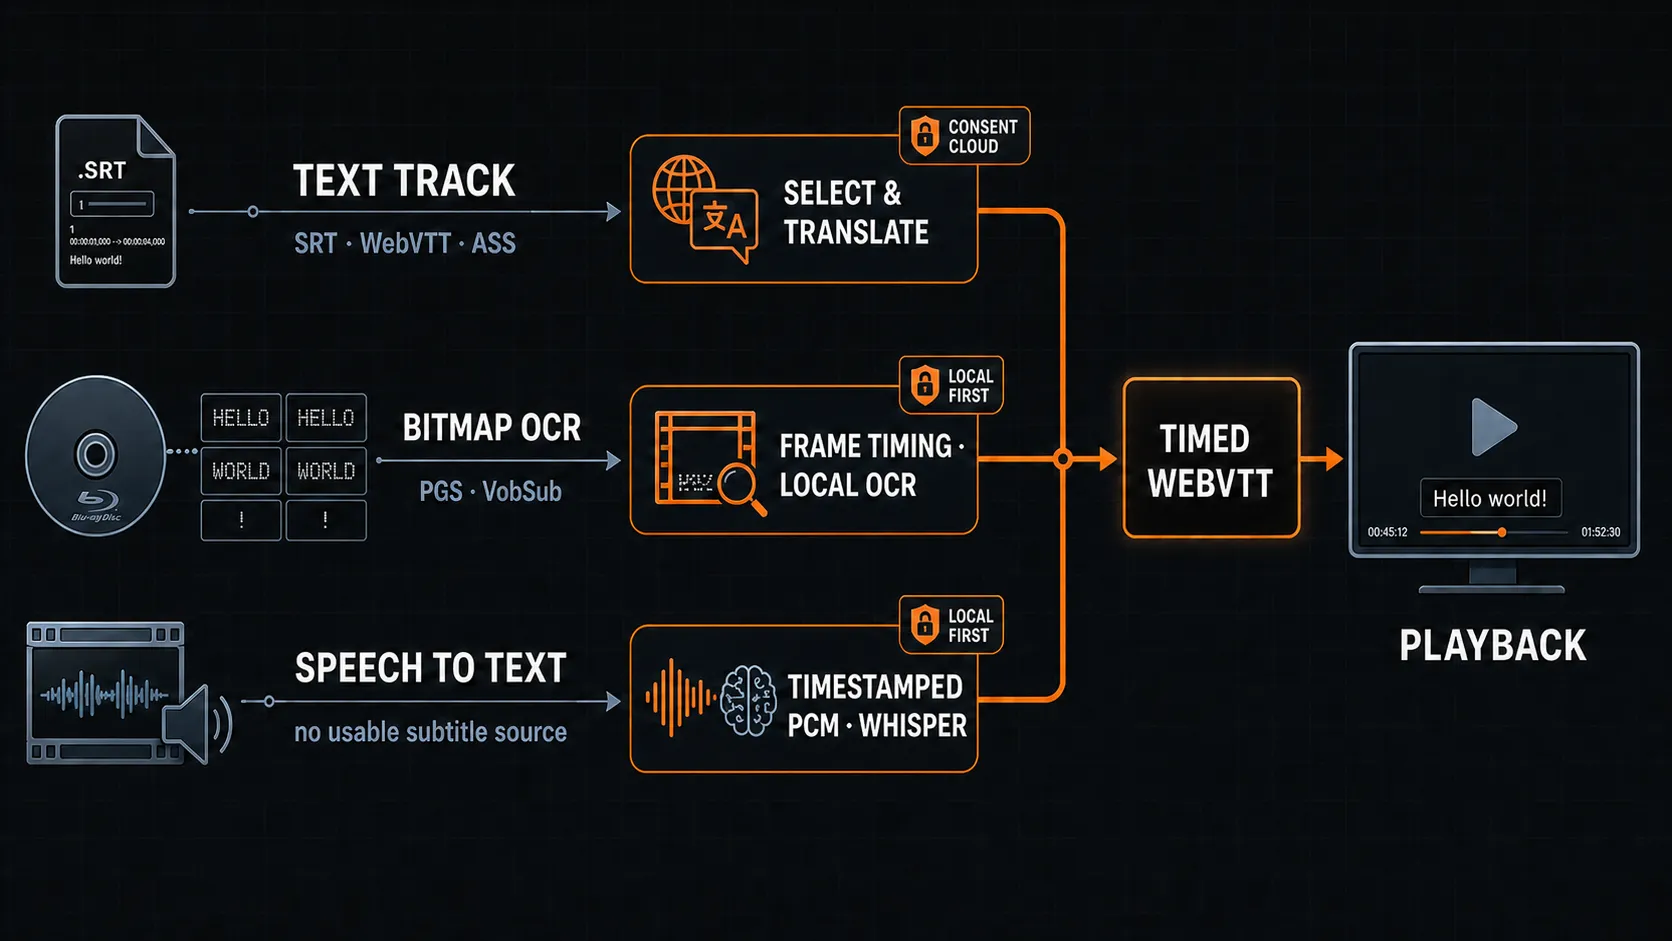
Ya hemos explicado cómo debería tratar los subtítulos un servidor multimedia: traducir las pistas de texto existentes, aplicar un OCR local a las pistas en imagen de los DVD y los Blu-ray, y recurrir a la escucha del diálogo cuando un archivo no contiene nada aprovechable. Tres rutas, y cada una termina en una pista de texto sincronizada.
Una arquitectura así solo vale lo que vale su comportamiento con soportes reales, de modo que probamos cada ruta con discos reales y películas reales. Tres detalles decidieron si el resultado resultaba aprovechable, y ninguno de ellos aparece en un archivo de prueba impecable.
Asociar cada imagen PGS a su línea
Un Blu-ray que solo contiene PGS constituye la primera prueba más difícil, y precisamente por eso es la adecuada. La pista no contiene texto, solo imágenes con sus tiempos, y el servidor tiene que asociar cada imagen a su línea antes de que pueda comenzar el reconocimiento:
- Leer el flujo con una ventana de análisis más amplia, porque FFmpeg no consigue determinar el tamaño de un flujo PGS con el análisis predeterminado.
- Construir el grafo de filtros a partir de las dimensiones propias del subtítulo, y no de las del vídeo.
- Leer los planos de color, ya que el decodificador entrega fotogramas con paleta cuyo plano alfa vale uniformemente cero, mientras que los glifos se encuentran en los planos de color.
- Restar la hora de inicio del contenedor, porque FFprobe informa de marcas de tiempo sin procesar mientras que FFmpeg reajusta su salida a cero.
El cuarto paso es el que desplaza discretamente cada línea cuando nadie lo tiene en cuenta. En el disco utilizado, el contenedor comenzaba a los 79 milisegundos, de modo que cada imagen habría llegado antes de tiempo. Con los cuatro pasos resueltos, el disco asoció 984 de sus 984 imágenes a sus líneas, y la misma corrección permite que VobSub también realice la asociación por marca de tiempo, 73 de 73 en el DVD que medimos.
También consideramos una detección de escenas para descartar los fotogramas transparentes que el PGS emite entre subtítulos, y la rechazamos. Dos líneas consecutivas con el mismo texto se interpretan como una ausencia de cambio de escena, de modo que una de ellas desaparece, y un sistema que pierde discretamente una línea de diálogo no merece tu confianza.
Transcripciones que conservan las frases completas
La ruta de audio tiene su propia trampa. Un motor de reconocimiento devuelve fragmentos de voz, y un subtítulo tiene que mostrarlos durante un tiempo legible: se trata de dos límites distintos. ¿Por qué mantenerlos separados? Porque el primero es un hecho sobre el audio y el segundo una decisión sobre la lectura. Quven limita la visualización de una línea a siete segundos, pero ese límite pertenece a la fase de sincronización, que divide las líneas largas en las pausas naturales y no decide dónde se corta el propio texto, de modo que una línea de diálogo de diez segundos y medio sigue siendo una sola frase. Las pruebas mantienen separados los dos límites, y por eso la transcripción de una película completa se lee como un diálogo.
El reconocimiento de voz en la tarjeta gráfica
Transcribir una película de dos horas solo con el procesador necesita unos ocho minutos y mantiene ocupados todos los núcleos, algo que nadie querría tener funcionando en segundo plano, y que tú no deberías tener que soportar. Por eso el reconocimiento puede ejecutarse en la tarjeta gráfica, con Metal en macOS y Vulkan en Windows y Linux, y en la tarjeta NVIDIA que medimos la fase de codificación pasó de 591 milisegundos a 15,7, mientras que una película de dos horas necesita aproximadamente dos minutos y medio con el procesador casi inactivo.
La selección desciende por una escala: GPU dedicada, GPU integrada, versión optimizada para el procesador, versión básica para el procesador, de modo que un equipo sin un adaptador aprovechable sigue transcribiendo, solo que más despacio. La tarjeta dedicada se elige en la lista de adaptadores, porque la enumeración llega en el orden de los controladores, y en la ruta del procesador Quven deja al menos un procesador libre.
Cómo es un subtítulo traducido
Revisamos línea por línea un episodio traducido completo, las 740 líneas, comparándolo con el original. Unas dieciocho resultaban imprecisas, y alrededor de una docena de ellas merecían una corrección, como una expresión idiomática mal resuelta o un fallo de continuidad: un subtítulo con el que se puede ver una película, y el editor de líneas se encarga del resto.
La ruta de audio también dio buenos resultados. La traducción de una película transcrita llegó completa, 1593 de 1593 líneas, sin líneas vacías ni restos del idioma de origen. Queda el límite propio del motor de reconocimiento, una línea gramaticalmente correcta que no coincide del todo con lo que dijo el actor, y por eso un subtítulo redactado por una persona, cuando existe, siempre tiene prioridad.
Qué parte corresponde a cada plan
La generación de un subtítulo a partir del audio se ejecuta en tu propio procesador y tu propia tarjeta gráfica, y está incluida en Pro, mientras que una transcripción ya producida sigue siendo reproducible gratuitamente para cualquier persona que pueda abrir el título. La traducción funciona de otra manera: el texto sale del equipo y pasa por un proveedor de modelos de lenguaje de pago, detrás de una cola de tareas que resiste los reinicios, de modo que cada película supone un coste real y cuantificable. Por eso la traducción con IA está incluida en Max y Lifetime, con una asignación semanal compartida por los servidores vinculados a la cuenta, y la página de planes recoge los detalles.
Las versiones prácticas son las guías sobre la traducción de subtítulos con IA y la generación de subtítulos para una película que no tiene ninguno.
Comunidad
Comentarios
0 comentarios
Todavía no hay comentarios. Inicia la conversación.